Jeśli masz dość miesięcznych subskrypcji drenujących Twój portfel lub limitów tokenów, które niszczą Twój impet akurat wtedy, gdy jesteś w szczytowej formie, nie jesteś sam. Skonfigurowanie własnego, lokalnego środowiska AI to najlepsze rozwiązanie, aby odzyskać kontrolę, chronić swój kod i przestać polegać na kaprysach serwerów w chmurze.
Dla tych, którzy odważą się wkroczyć w tę dziedzinę, zwłaszcza z wydajnymi maszynami, takimi jak nowy Mac mini M4, ekosystem może wydawać się labiryntem. Kluczem jest jednak zrozumienie, że nie potrzeba jednego magicznego narzędzia, ale raczej zestawu narzędzi składającego się z silnika wnioskowania, wyspecjalizowanego modelu kodu i interfejsu, który działa jak autonomiczny agent.
Filary lokalnego asystenta ds. kodów
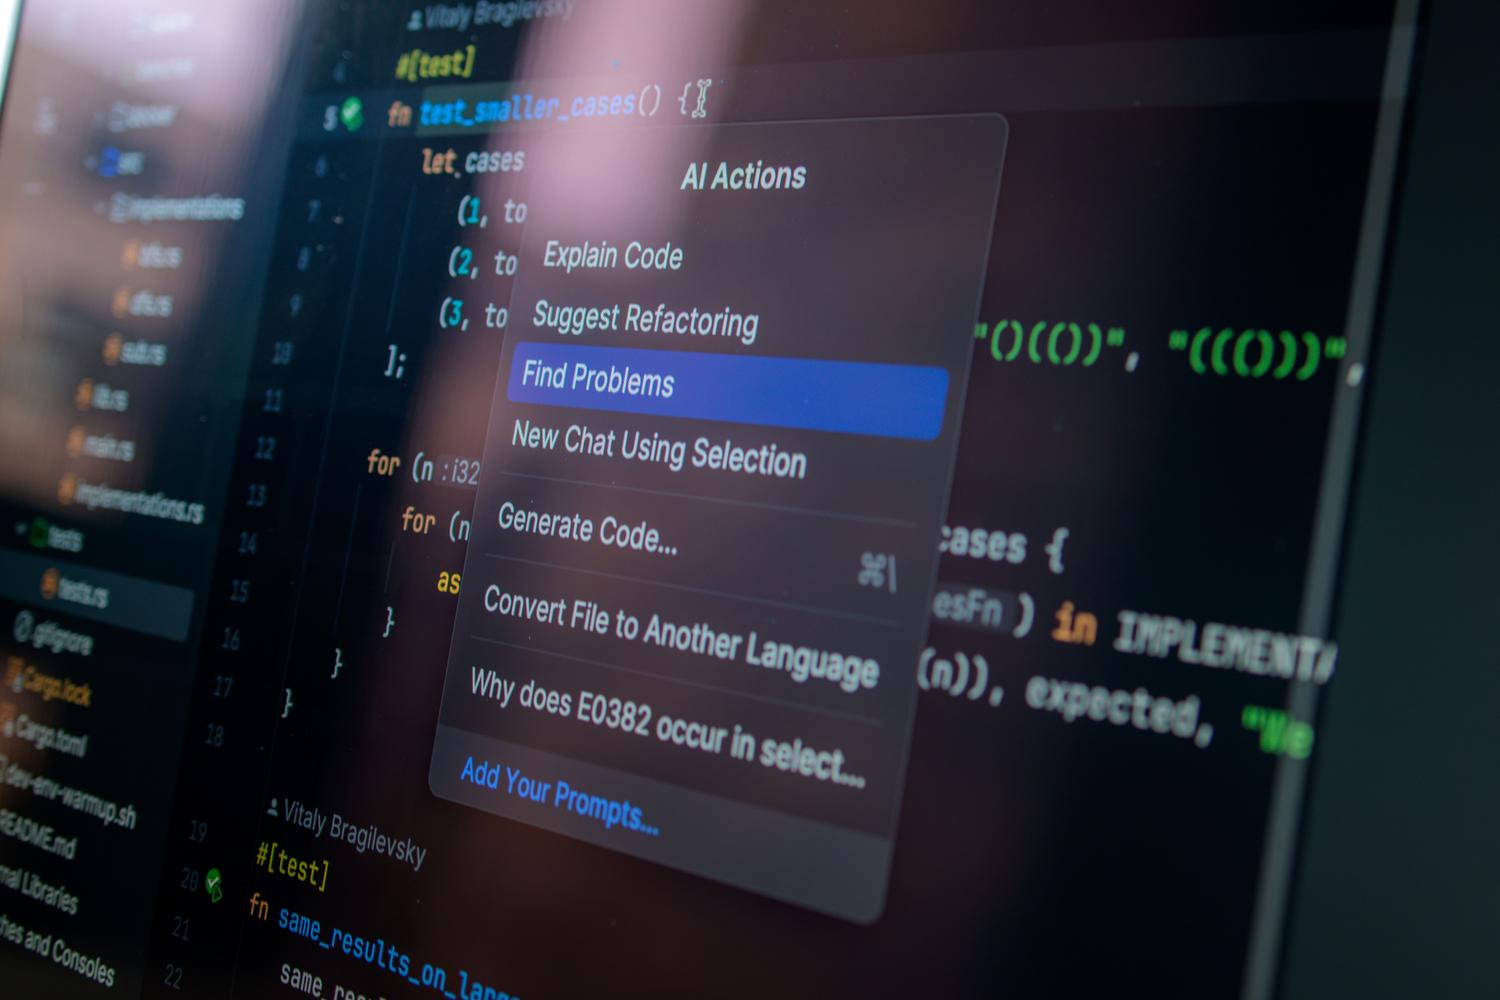
Aby wszystko działało bez konieczności kopiowania i wklejania fragmentów kodu na potęgę, potrzebne są cztery dobrze zdefiniowane warstwy. Pierwszą z nich jest środowisko wykonawcze (runtime) , w którym Ollama i LM Studio obecnie królują ze względu na łatwość obsługi modeli za pośrednictwem interfejsów API zgodnych z OpenAI. Kolejną warstwą jest model języka (LLM) , czyli mózg, który odpowiada za rozumowanie; w tym przypadku rodzina Qwen2.5-Coder stała się złotym standardem pod względem równowagi między rozmiarem a pojemnością.
Trzecim elementem jest klient lub interfejs IDE , taki jak rozszerzenie Continue dla VS Code, które zapewnia autouzupełnianie i zintegrowany czat. Wreszcie istnieją agenci akcji , czyli bardziej zaawansowane narzędzia, takie jak Cline czy Aider, zdolne do odczytywania całych plików, wykonywania poleceń w terminalu i proponowania rzeczywistych zmian w repozytorium pod nadzorem użytkownika.
Zalecane modele na podstawie Twojego sprzętu
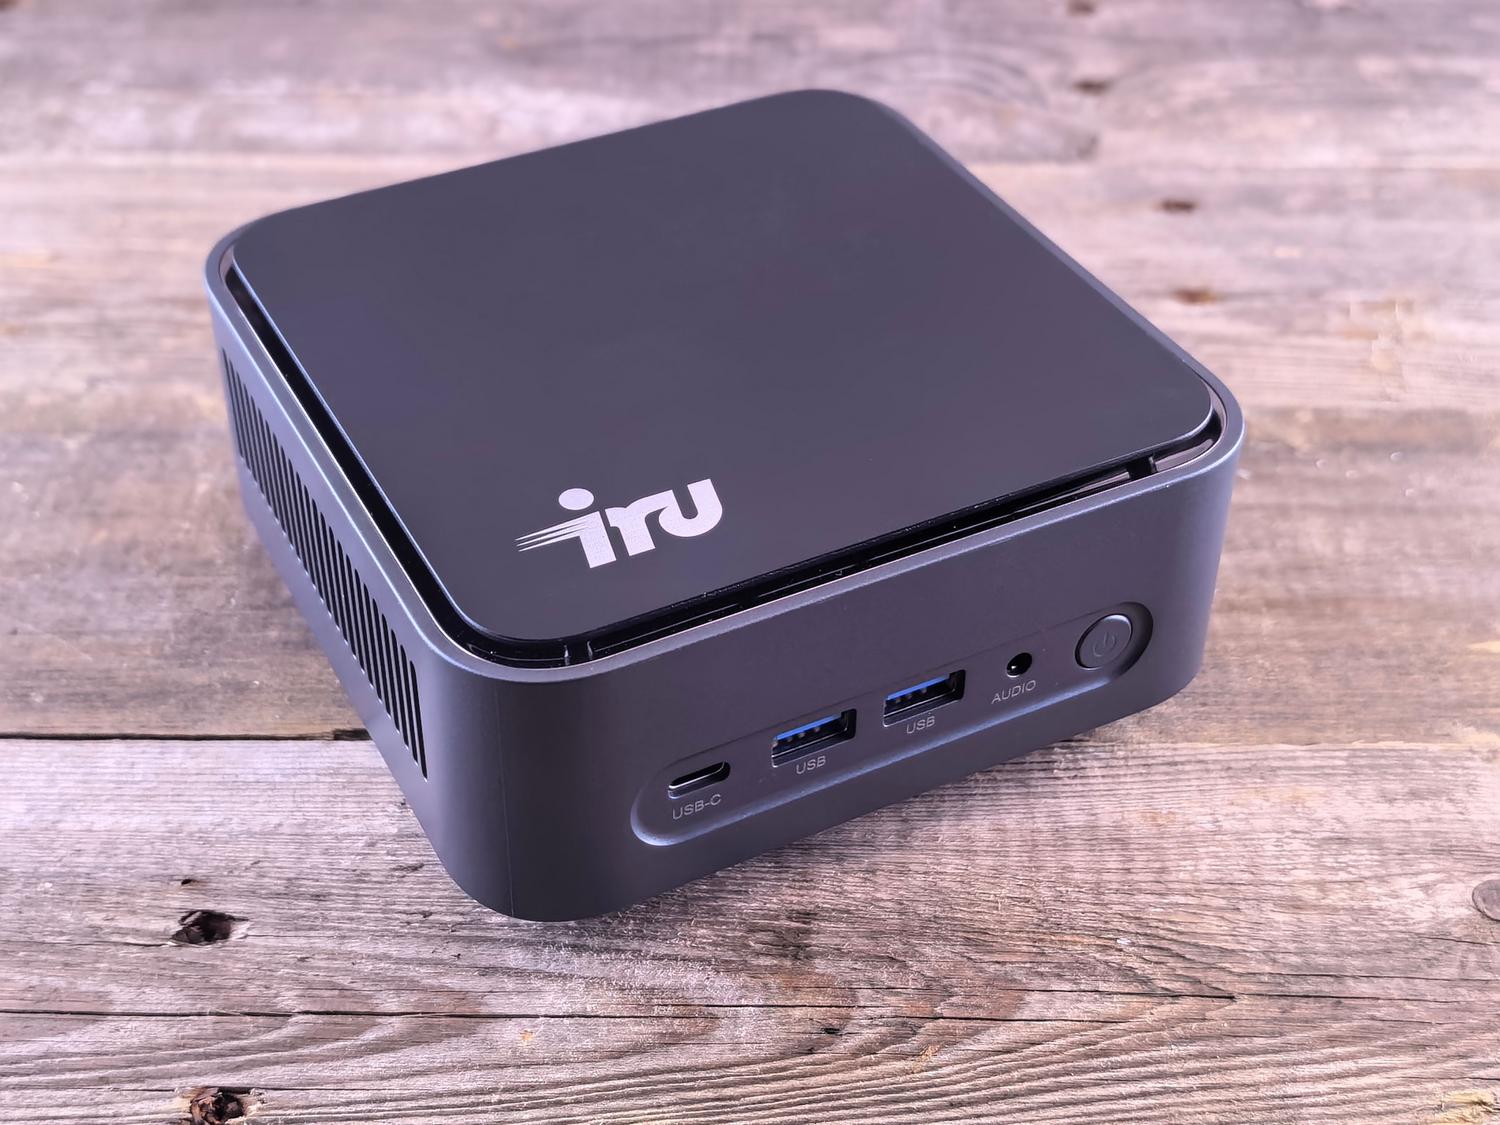
Nie wszystkie modele będą pasować do każdego komputera. Złota zasada brzmi, że pamięć zunifikowana, czyli VRAM , stanowi prawdziwe wąskie gardło, znacznie bardziej niż sama moc procesora. Jeśli masz podstawowy komputer z 16 GB pamięci RAM, modele z 7 GB lub 8 GB będą najlepszym wyborem do szybkich zadań i rozmów na czacie.
- Qwen2.5-Coder 1.5B: Idealne do natychmiastowego automatycznego uzupełniania (autouzupełnianie za pomocą karty) bez spowalniania komputera.
- Qwen2.5-Coder 7B/14B: Idealne rozwiązanie dla tych, którzy szukają równowagi między szybkością i logicznym rozumowaniem.
- Qwen2.5-Coder 32B: Dla posiadaczy 24 GB pamięci VRAM lub więcej, którzy potrzebują poważne i profesjonalne kodowanie która zbliża się jakością do modeli komercyjnych.
- DeepSeek-Coder-V2 Lite: Brutalna alternatywa dla trudnych zadań logicznych lub skomplikowanych algorytmów.
Narzędzia i agenci: których wybrać?
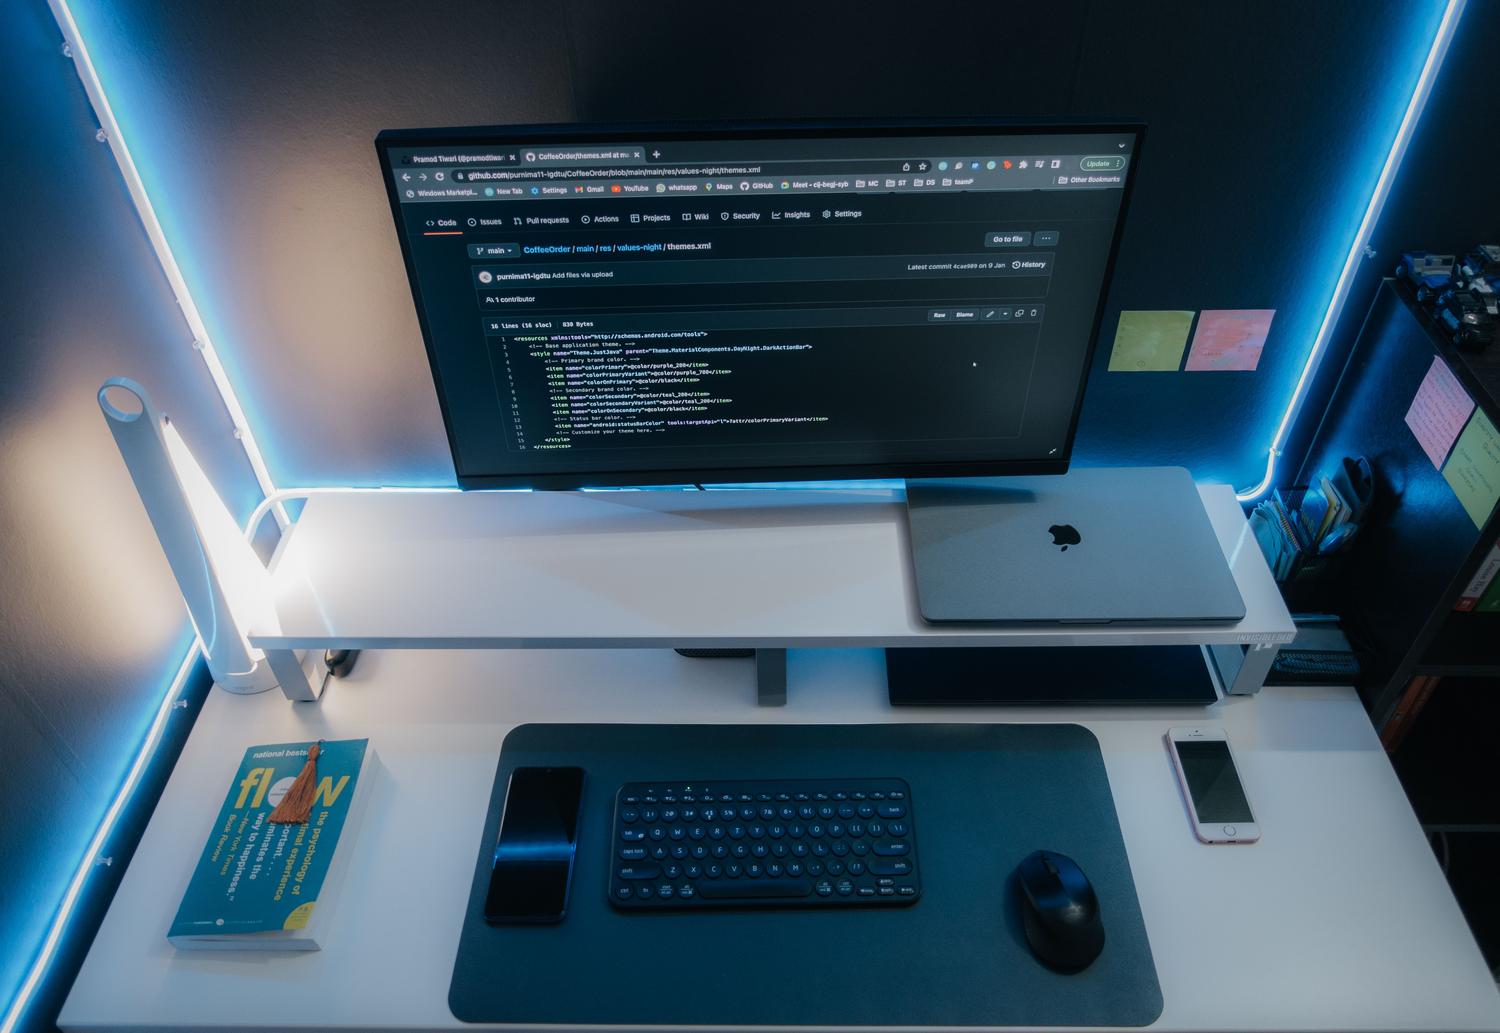
W zależności od tego, jak dużą autonomię chcesz dać sztucznej inteligencji, masz kilka opcji. Jeśli wolisz coś zintegrowanego z edytorem, Continue będzie idealnym punktem wyjścia. Jeśli szukasz agenta, który może automatycznie edytować wiele plików i zarządzać zatwierdzeniami Git, Aider to najlepsze, zaawansowane narzędzie terminalowe, ponieważ optymalizuje wykorzystanie tokenów poprzez mapy repozytoriów.
Z drugiej strony mamy Goose , niezwykle wszechstronnego agenta open source, który może współpracować z systemem plików i być rozszerzany za pośrednictwem serwerów MCP. Dla tych, którzy szukają czegoś bardziej wizualnego, AnythingLLM umożliwia lokalne zarządzanie wiedzą i indeksowanie dokumentów, choć jest to raczej narzędzie do zwiększania produktywności niż narzędzie dla programistów. Pojawiają się również nowe projekty, takie jak OllamaCode , które koncentrują się na umożliwieniu sztucznej inteligencji nie tylko pisania kodu, ale także jego wykonywania i testowania w czasie rzeczywistym.
Konfiguracja krok po kroku dla wydajnego przepływu pracy
Aby wszystko działało idealnie, najlepiej zacząć od zainstalowania Ollama i pobrania modelu, który najlepiej pasuje do Twojej pamięci (na przykład ollama pull qwen2.5-coder:14bGdy model zareaguje poprawnie na konsoli, łączymy go z programem VS Code za pomocą rozszerzenie Kontynuujskonfigurowanie adresu URL lokalnego hosta, aby rozmowy i edycje odbywały się na Twoim komputerze.
Jeśli chcesz przenieść wszystko na wyższy poziom, możesz zainstalować Cline , aby mieć agenta, który sugeruje zmiany w powłoce i plikach, zawsze pytając o zgodę przed wykonaniem jakichkolwiek operacji. Aby zapewnić bardziej stabilny przepływ pracy, Aider pozwoli Ci wykonywać refaktoryzacje wielu plików z niezwykłą dokładnością, wykorzystując wiedzę agenta na temat Twojej struktury Gita.
Prywatność, koszty i wydajność
Główną zaletą tego podejścia jest absolutna prywatność ; Twoje tajemnice handlowe i klucze API nigdy nie trafiają na żaden serwer zewnętrzny, co jest niezwykle istotne, jeśli pracujesz w sektorach regulowanych. Co więcej, po zainwestowaniu w sprzęt, koszt tokena spada dosłownie do zera, eliminując frustrację związaną z limitami użytkowania w wersjach Cloud Pro.
Pod względem wydajności, opóźnienie drastycznie spada, ponieważ nie ma przesyłania danych w obie strony przez sieć. Należy jednak zachować ostrożność z pamięcią podręczną KV ; jeśli zauważysz nagłe spowolnienie sztucznej inteligencji (AI), prawdopodobnie zabrakło pamięci VRAM, a system korzysta ze zwykłej pamięci RAM, która jest znacznie wolniejsza. Rozwiązaniem jest zmniejszenie rozmiaru kontekstu lub użycie mniejszego modelu.
Wskazówki, jak nie zepsuć projektu
Podanie kluczy do terminala sztucznej inteligencji bez nadzoru może być niebezpieczne. Najrozsądniejszym rozwiązaniem jest zastosowanie zasady restrykcyjnych uprawnień : pozwól sztucznej inteligencji najpierw odczytać pliki, następnie zaproponować plan, a dopiero potem zapisać zmiany. Nigdy nie zezwalaj agentowi na wykonywanie poleceń usuwania plików lub instalacji zbiorczych bez uprzedniego zweryfikowania dokładnego polecenia.
Zaleca się pracę w dedykowanych gałęziach Gita do testowania sztucznej inteligencji. W ten sposób, jeśli agent zdecyduje się na refaktoryzację i zepsuje cały projekt, można powrócić do jednego polecenia. Zwycięskie podejście to: mały cel, inspekcja kontekstu, zatwierdzenie ograniczonej poprawki i walidacja z rzeczywistymi testami przed ostatecznym zatwierdzeniem.
Połączenie środowiska wykonawczego takiego jak Ollama, wydajnych modeli z serii Qwen oraz autonomicznych agentów, takich jak Aider lub Cline, przekształca komputer osobisty w samodzielną stację roboczą do tworzenia oprogramowania. Priorytetowo traktując pamięć ujednoliconą i zarządzając uprawnieniami wykonywania, każdy programista może wyeliminować konieczność korzystania z limitów w chmurze i cieszyć się płynnym, prywatnym i całkowicie darmowym przepływem pracy.