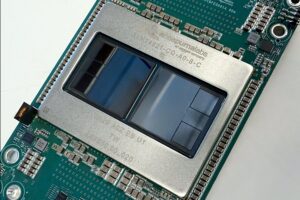
Firma OpenAI wykonała znaczący krok w swojej strategii niezależności technologicznej, prezentując pierwsze wyniki uzyskane dzięki autorskiemu procesorowi AI o nazwie Jalapeño. Opracowany we współpracy z Broadcom, ten skoncentrowany na wnioskowaniu układ przewyższył akceleratory Nvidia GB200 i GB300 w dwóch kluczowych parametrach: mocy obliczeniowej na wat i szybkości reakcji. Dane, opublikowane na konferencji Hot Chips i opublikowane przez takie media jak Bloomberg i The Verge, plasują OpenAI w bezprecedensowej pozycji w wyścigu o sprzęt AI.
To nie jest błaha wiadomość. Do tej pory OpenAI opierało się niemal wyłącznie na procesorach Nvidia do obsługi swoich modeli, zarówno w fazie szkolenia, jak i wnioskowania – czyli gdy system odpowiada na zapytania użytkownika. Dzięki Jalapeño firma dąży do obniżenia kosztów operacyjnych i uzyskania kontroli nad infrastrukturą, nie rezygnując jednak całkowicie z Nvidii. Według Richarda Ho, szefa działu sprzętu w OpenAI, układ oferuje to, co nazywa „najlepszymi z obu światów”: wysoką przepustowość umożliwiającą jednoczesną obsługę wielu klientów i niskie opóźnienia w aplikacjach interaktywnych.

Czym jest Jalapeño i jak działa?
Jalapeño to układ scalony o przeznaczeniu aplikacyjnym (ASIC), zaprojektowany od podstaw do realizacji jednego zadania: uruchamiania wstępnie wytrenowanych modeli językowych. W przeciwieństwie do procesorów graficznych Nvidii, które są procesorami ogólnego przeznaczenia, ten układ jest zoptymalizowany pod kątem fazy wnioskowania, w której system przetwarza żądanie i generuje odpowiedź. Nie jest on przeznaczony do trenowania modeli, co pozostaje domeną procesorów graficznych Nvidii i które OpenAI będzie nadal wykorzystywać w tym celu.
Konstrukcja układu koncentruje się na redukcji wąskich gardeł, które zazwyczaj występują podczas wnioskowania, takich jak przesyłanie danych między pamięcią a jednostkami obliczeniowymi. Według firmy, Jalapeño integruje dużą sekcję obliczeniową z sześcioma blokami pamięci o wysokiej przepustowości (HBM), co pozwala na lokalne przechowywanie danych i unikanie niepotrzebnych transferów. Co więcej, układ może aktywować odpowiednią kombinację zasobów dla każdej fazy przetwarzania, poprawiając zarówno wydajność sztucznej inteligencji, jak i efektywność energetyczną.
Wyniki testów porównawczych z Nvidią
Testy przeprowadzono z wykorzystaniem publicznej platformy InferenceX firmy SemiAnalysis, która mierzy wydajność systemów AI w warunkach rzeczywistych. OpenAI porównał Jalapeño z najlepszymi wynikami uzyskanymi przez superchipy Nvidia GB200 i GB300, które były dostępnymi testami porównawczymi w momencie przeprowadzania testów. Wyniki pokazały, że Jalapeño osiąga od 1,5 do 1,9 razy więcej pracy AI na wat, a opóźnienie między nimi jest od 1,7 do 3,6 razy niższe. Modele użyte w zestawie testowym to GPT-OSS 120B, DeepSeek R1 i Kimi K3 , od modeli o otwartej wadze po modele graniczne.
Te liczby są szczególnie istotne, ponieważ efektywność energetyczna stała się jednym z głównych wyzwań branży. Centra danych AI zużywają ogromne ilości energii elektrycznej, a zmniejszenie zużycia na jednostkę pracy może prowadzić do znacznych oszczędności. Według Richarda Ho, Jalapeño działa z mocą około 700 watów, co jest stosunkowo niską wartością jak na akcelerator inferencyjny, i może obniżyć koszty operacyjne o około 50% w porównaniu z konwencjonalnymi procesorami graficznymi, jak twierdzi Hock Tan, prezes Broadcom.
Współpraca z Broadcom i plan działania
Rozwój Jalapeño jest wynikiem strategicznego sojuszu między OpenAI i Broadcom, ogłoszonego w październiku 2025 roku. Broadcom wnosi swoją wiedzę specjalistyczną w zakresie projektowania układów scalonych, sieci i produkcji, podczas gdy OpenAI wykorzystuje własne modele sztucznej inteligencji, aby przyspieszyć proces projektowania. Proces od projektu początkowego do produkcji końcowej, czyli ostatniego etapu przed produkcją, trwał zaledwie dziewięć miesięcy – to rekordowy czas dla zaawansowanego półprzewodnika.
OpenAI pracuje już nad drugą generacją procesora i ma w fazie rozwoju trzecią. Firma planuje wdrożyć pierwsze systemy z Jalapeño w bardzo małych partiach do końca 2026 roku i znacząco rozszerzyć jego zastosowanie w 2027 roku. Według Bloomberga, wdrożenie odbędzie się w centrach danych Microsoftu i innych partnerów, a skala ma osiągnąć 10 gigawatów mocy obliczeniowej do 2029 roku. Przedstawione wyniki mają jednak charakter wstępny i nie zostały jeszcze zweryfikowane w środowisku produkcyjnym na dużą skalę.
Konsekwencje dla rynku i użytkowników
Pojawienie się Jalapeño nie oznacza, że OpenAI porzuca Nvidię. Firma podkreśla, że Nvidia pozostaje kluczowym partnerem, zwłaszcza w zakresie trenowania modeli, a zapotrzebowanie na moc obliczeniową jest tak wysokie, że wymaga współpracy wielu dostawców. W rzeczywistości OpenAI współpracuje również z AMD i Cerebras, a jej strategia polega na budowaniu heterogenicznej infrastruktury, w której każde obciążenie jest przypisane do najwydajniejszego sprzętu.
Dla użytkowników i deweloperów ta wiadomość ma bezpośrednie konsekwencje. Jeśli Jalapeño spełni swoje obietnice, koszt tokena wnioskowania może spaść o 30–50% w ciągu najbliższych 18 miesięcy, umożliwiając startupom i firmom oferowanie tańszych usług AI z mniejszymi opóźnieniami. Co więcej, konkurencja na rynku układów AI rośnie, co może przełożyć się na niższe ceny i większy wybór dla użytkowników końcowych.
Na koniec warto zauważyć, że testy nie obejmowały porównania z nową architekturą Vera Rubin firmy Nvidia, która dopiero niedawno trafiła do sprzedaży. W związku z tym przewaga Jalapeño może zmaleć, gdy Nvidia wypuści jej kolejną generację. Mimo to postępy w OpenAI pokazują, że branża sztucznej inteligencji wkracza w nową fazę, w której sprzęt dedykowany będzie odgrywał coraz ważniejszą rolę. Wyścig o wydajność i szybkość dopiero się rozpoczyna.